
Искусственный интеллектуперся в потолок: количество используемых для обучения данных ограничено, и они быстро заканчиваются. В связи с этим стартапы прибегают к помощи синтетических данных — информации, сгенерированной другим нейросетям.
ИИ-стартап Anthropic применил синтетические данные для обучения одной из своих флагманских моделейClaude 3.5 Sonnet. Meta доработала свои нейросетиLlama 3.1с помощью созданных ИИ данных. OpenAI также применяет синтетическую информацию для обученияo1— «рассуждающего» искусственного интеллекта.
TechCrunchобратили вниманиена преимущества и недостатки такого подхода.
Аннотация
Системы искусственного интеллекта — это статистические машины. Они обучаются на большом количестве примеров и изучают закономерности для дальнейших предсказаний.
Аннотации — текстовые метки, обозначающие смысл или части данных — являются ключевым элементом в этих примерах. Они служат ориентирами, «обучая» модель различать предметы, места и идеи.
Например, если нейросети показать множество фотографий кухни и пометить их словом «кухня», со временем она начнет ассоциировать ее общие характеристики вроде наличия холодильника или столешницы. После обучения модель сможет распознать фотографию кухни, которая раньше ей не показывалась.
В процессе обучения важно грамотно классифицировать аннотации. Например, если изображения с кухнями помечать словом «корова», ИИ будет связывать холодильник с животным.
Необходимость применения помеченных данных создал целый рынок аннотационных услуг, которыйоцениваетсяв $838,2 млн, а в течение 10 лет достигнет $10,34 млрд.
В некоторых случаях маркировка данных требует специализированных знаний и опыта, например, если это касается математики. Существуют фирмы, специализирующиеся на аннотации данных. Работа в таких компаниях может быть как высокооплачиваемой, так и наоборот. В развивающихся странах работникиполучаютменее $2 в час.
Нужно заменить людей
Платить маркировщикам данных иногда дорого, плюс они способны ошибаться. Также само получение информации может быть затратным. Shutterstock взимает десятки миллионов долларов с ИИ-поставщиков за доступ к своим архивам. Reddit заработал сотни миллионов на лицензировании информации для Google, OpenAI и других.
Наконец, данные становится все труднее получить. Более 35% из 1000 лучших веб-сайтов блокируют доступ для OpenAI. Если тенденция сохранится, ИИспособенисчерпать всю общедоступную информацию к 2026–2032 годам.
Все это, а также риски судебных исков за использование лицензированной информации, привело к необходимости генерировать синтетическую информацию.
Синтетические альтернативы
Если данные — это нефть, синтетическая информация позиционируется как биотопливо, которое можно создать без негативных внешних последствий, отметил кандидат наук Вашингтонского университета Ос Киз.
«Вы можете взять небольшой стартовый набор данных и моделировать и экстраполировать новую информацию из него», — отметил он.
ИИ-индустрия взяла технологию на вооружение и начала применять. В декабре компания Writer представила модель Palmyra X 004, обученную почти полностью на синтетических данных. Разработкаобошласьв $700 000 по сравнению с $4,6 млн, которые затратил OpenAI за создание нейросети аналогичного размера.
Открытые моделиPhiот Microsoft частично обучались на синтетических данных, также как иGemmaот Google. Этим летом Nvidiaпредставиласемейство моделей, предназначенных для создания синтетической обучающей информации, а ИИ-стартап Hugging Faceвыпустил«самый большой» набор информации для настройки ИИ, состоящий из искусственного текста.
Генерация синтетических данных стала бизнесом, стоимость которогоможет вырастидо $2,34 млрд к 2030 году.
Синтетические риски
Применение синтетических данных несет в себе определенные риски. Если информация, применяемая для создания искусственных сведений, имеет предвзятость или ограничения, результат будет испорчен.
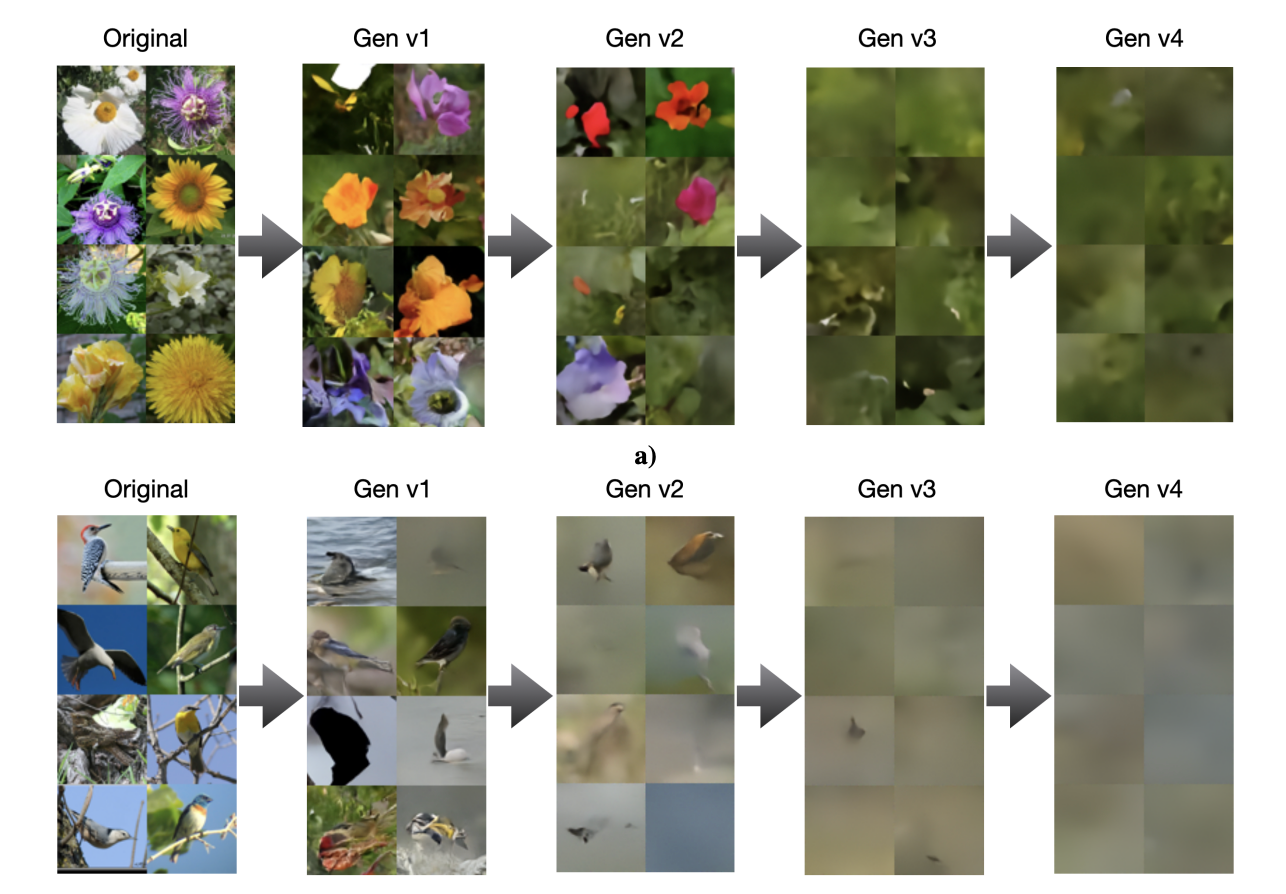
Чрезмерное применение синтетических данных в ходе обучения нейросетей приводит к снижению качества и разнообразия модели, говорится висследованииУниверситетов Райса и Стэнфорда.
Большие нейросети вроде o1 способны создавать более сложные для обнаружения галлюцинации, что приведет к снижение точности ИИ, обученного на подобных данных.
Опубликованное в июлеисследованиепоказывает, что модели, обученные на ошибочных данных, генерируют еще более неправдивую информацию. Это создает петлю деградации для последующих нейросетей. Впоследствии искусственный интеллект может давать ответ, вообще никак не связанный с вопросом.
Другоеисследованиенаглядно показало снижение качества работы модели на примере изображений.
Старший научный сотрудник Института искусственного интеллекта Аллена Лука Солдайни считает, что применение синтетических данных целесообразно в случае их тщательной проверки, фильтрации и сопоставления с реальной информацией.
Несоблюдение этого требования может привести к краху модели, она станет менее «творческой» и более предвзятой в своих выводах, что в конечном итоге серьезно снизит ее функциональность.
«Конвейеры синтетических данных не являются самосовершенствующимися машинами. Их результаты должны быть тщательно проверены и улучшены, перед их использованием для для обучения», — отметил он.
Ранее CEO OpenAI Сэм Альтманотметил, что когда-нибудь ИИ будет создавать синтетические данные, достаточно хорошие для эффективного самообучения.
Напомним, в декабре соучредитель OpenAI Илья Суцкеверспрогнозировалконец эпохи предварительного обучения искусственного интеллекта и предсказал появление суперинтеллекта.





